Plik llms.txt to prosty plik tekstowy, który ma ułatwić sztucznej inteligencji czytanie Twojej strony. Problem w tym, że w 2026 roku prawie żaden bot AI go nie pobiera, a Google pisze wprost, że takich dodatkowych plików dla AI nie potrzebujesz. Poniżej pokazuję, co mówią badania z serwerów i na czym naprawdę warto skupić czas.
Wokół pliku llms.txt narosło sporo obietnic. Że wystarczy go dodać, a ChatGPT, Gemini czy Perplexity zaczną chętniej sięgać po informacje o Twojej firmie. W 2026 roku mamy już twarde dane z logów serwerów i jasne stanowisko Google, więc decyzję możesz podjąć na podstawie faktów, a nie marketingu. Przejdźmy przez to po kolei.
Czym jest plik llms.txt i skąd się wziął?
Plik llms.txt to pomysł Jeremy'ego Howarda, opublikowany 3 września 2024 roku. Założenie jest proste: zwykła strona WWW jest zrobiona dla człowieka, więc ma menu, reklamy, skrypty i mnóstwo kodu, przez który model językowy musi się przebić. Plik llms.txt ma zebrać w jednym miejscu uporządkowany, krótki opis serwisu i linki do najważniejszych podstron, żeby AI nie musiała zgadywać, co jest ważne.
Z technicznego punktu widzenia to plik w formacie Markdown, który najczęściej umieszczasz w katalogu głównym domeny, pod adresem twojadomena.pl/llms.txt. Jedyny obowiązkowy element to nagłówek H1 z nazwą firmy lub serwisu. Dalej zwykle dodaje się krótkie streszczenie w cytacie, a pod nagłówkami H2 listę linków z jednozdaniowym opisem. Specyfikacja doczekała się wersji drugiej (zaktualizowanej 10 sierpnia 2026 roku), a obecność pliku llms.txt sprawdza już nawet audyt Lighthouse w przeglądarce Chrome. To ważne: standard istnieje i jest opisany na llmstxt.org. Pytanie brzmi tylko, czy ktokolwiek go używa.
Czy sztuczna inteligencja w ogóle czyta plik llms.txt?
To jest pytanie, od którego trzeba zacząć, zanim poświęcisz na plik choćby godzinę. Odpowiedź z danych jest prosta: dziś boty AI prawie go nie czytają. W jednym z badań z 2026 roku przeanalizowano logi serwerów 83 stron, które miały wdrożony plik llms.txt, w okresie od 27 kwietnia do 19 lipca 2026. W tym czasie te same boty, które pobierały plik robots.txt tysiące razy, plik llms.txt pobierały pojedyncze razy.
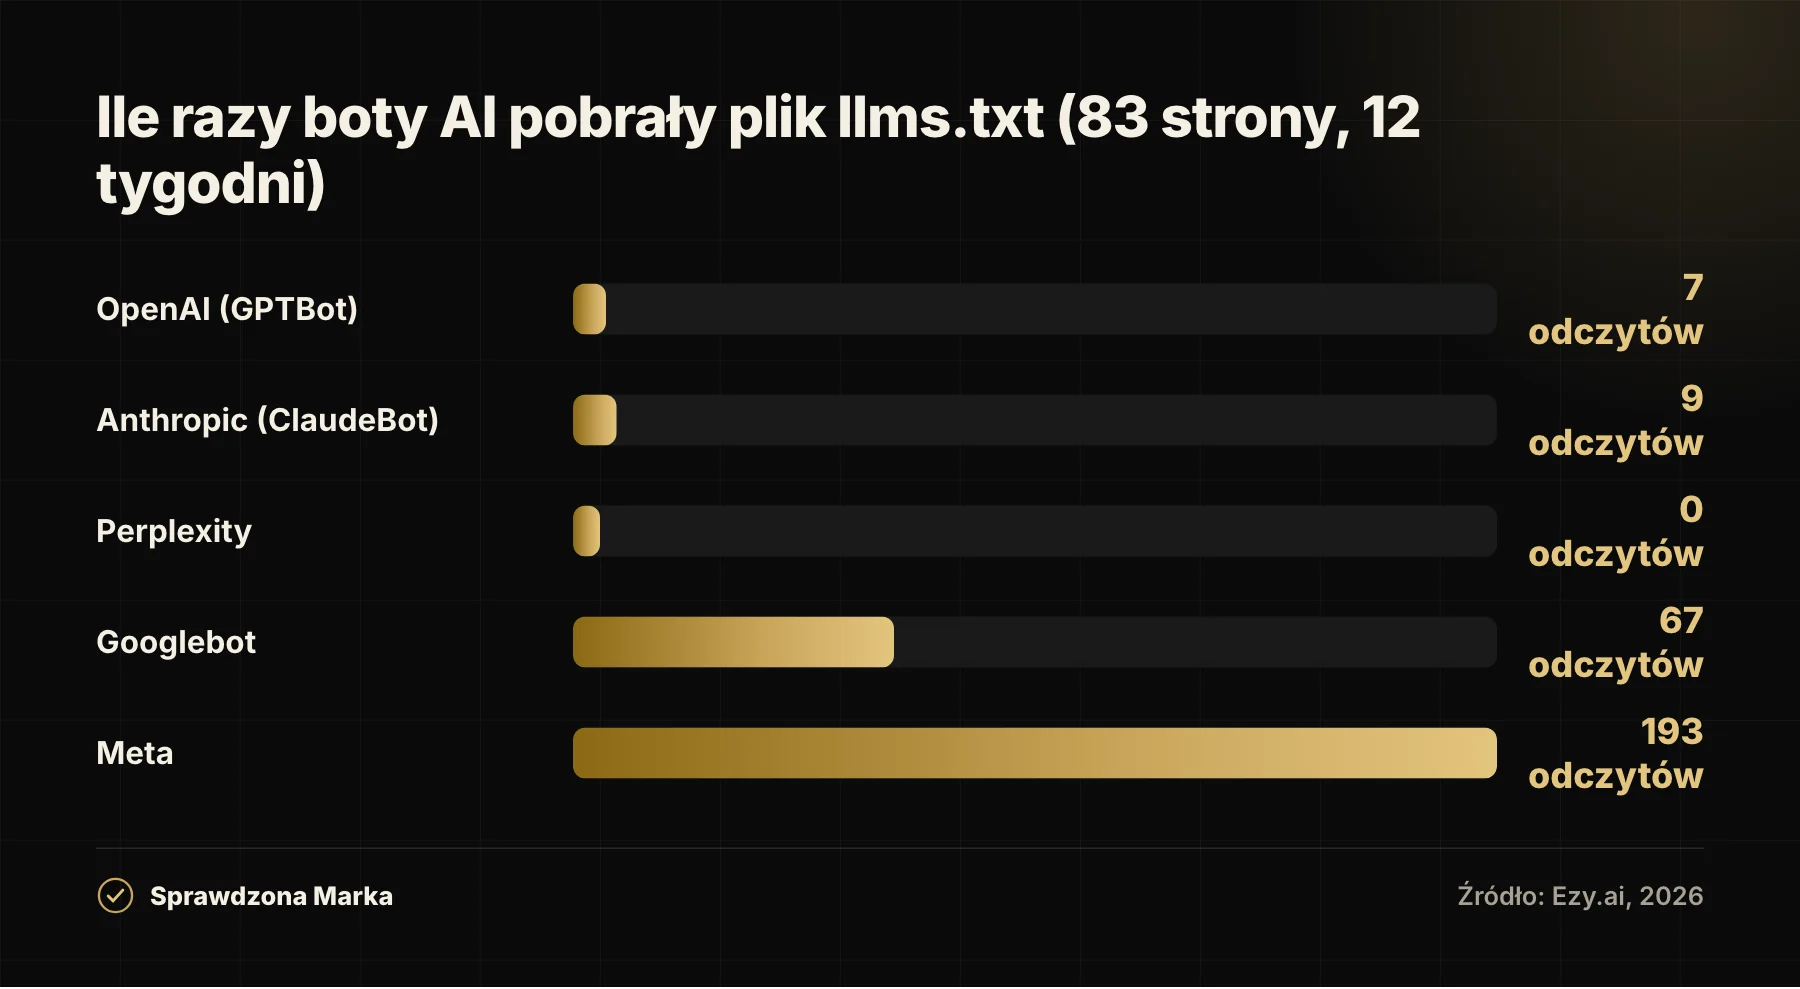
Liczby mówią same za siebie. GPTBot od OpenAI sięgnął po llms.txt 7 razy, a po robots.txt prawie 4 tysiące razy. ClaudeBot od Anthropic odpowiednio 9 i ponad 3 tysiące razy. Bot Perplexity nie pobrał pliku llms.txt ani razu, choć robots.txt odwiedził 775 razy. Wyjątkiem był crawler Meta, który plik llms.txt pobierał częściej niż robots.txt.
| Bot AI | Odczyty llms.txt | Odczyty robots.txt |
|---|---|---|
| OpenAI (GPTBot) | 7 | 3 990 |
| Anthropic (ClaudeBot) | 9 | 3 120 |
| Perplexity | 0 | 775 |
| Googlebot | 67 | 5 125 |
| Meta (Meta-ExternalAgent) | 193 | 172 |
Skąd ta różnica? Robots.txt to stary, powszechnie respektowany standard, który mówi botom, czego nie wolno im pobierać, więc crawler sprawdza go niemal przy każdej wizycie. Plik llms.txt jest na razie tylko propozycją, której żaden duży dostawca nie wpisał na stałe do swojego crawlera. Bot nie ma więc powodu, by go szukać, i zwykle tego nie robi. To nie kwestia złej woli, tylko tego, że standard nie został przyjęty tam, gdzie zapadają decyzje o pobieraniu treści.
John Mueller z Google porównał plik llms.txt do dawnego znacznika meta keywords, który dziś jest już reliktem. Zwrócił uwagę, że żadna usługa AI nie potwierdziła, że z niego korzysta, i że widać to po logach serwera: boty nawet nie sprawdzają, czy plik istnieje. To mocne słowa od osoby, która na co dzień tłumaczy, jak działa wyszukiwarka.
Co mówią badania z 2026 roku?
Rozjechały się dwie rzeczy: moda na publikowanie pliku i jego realne wykorzystanie. Firma Ahrefs przeanalizowała 137 tysięcy domen i ustaliła, że plik llms.txt publikuje już 28 procent z nich, mimo że żadna duża platforma AI oficjalnie go nie wspiera. W tym samym badaniu okazało się, że 97 procent plików llms.txt nie dostało ani jednego zapytania. Innymi słowy: firmy je tworzą, a boty je ignorują.
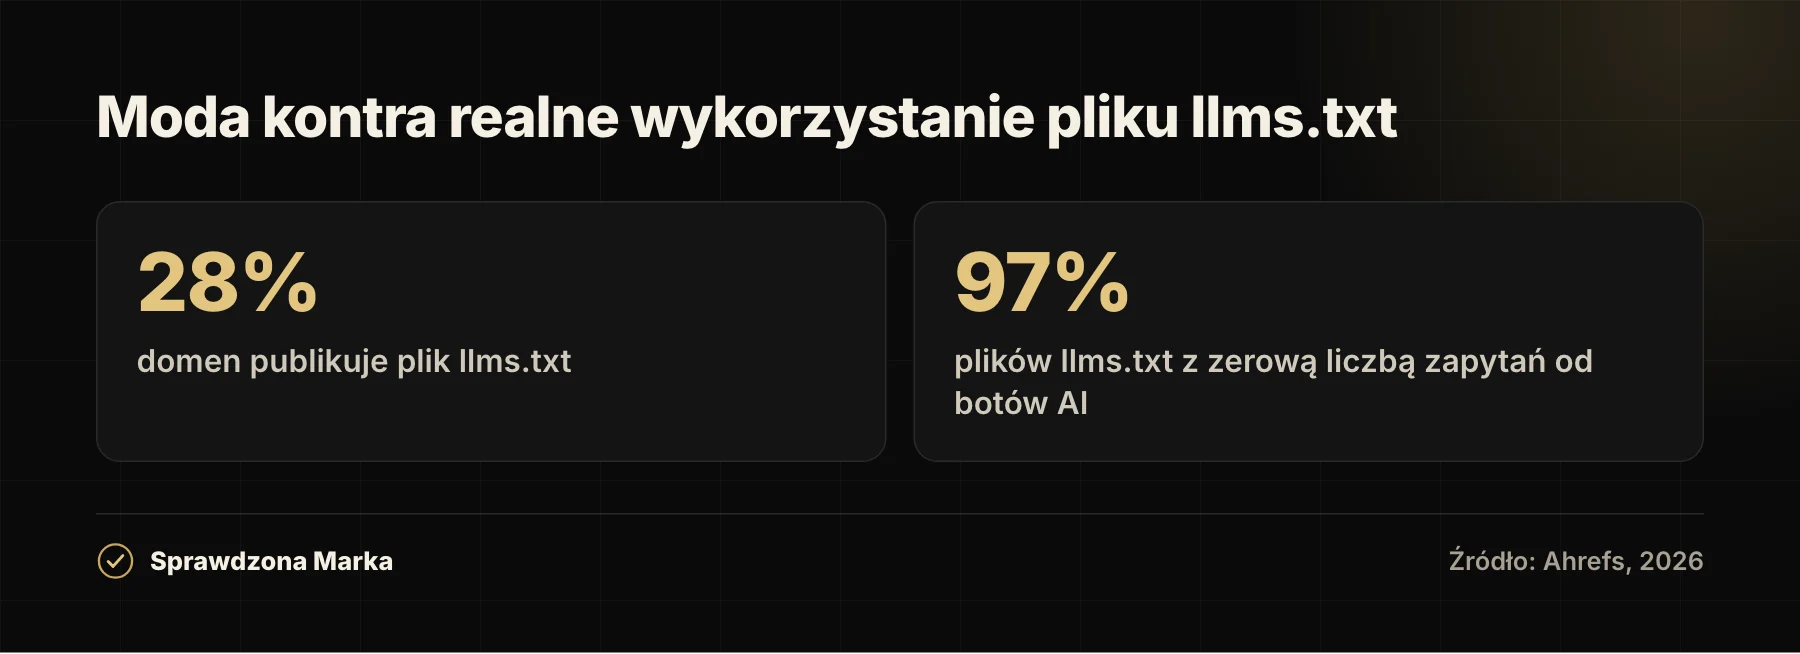
Dla właściciela strony te 97 procent plików bez ani jednego zapytania znaczy w praktyce jedno: ogromna większość osób, które wdrożyły llms.txt, nigdy nie doczekała się tego, po co to robiła. Plik leży na serwerze, a żaden bot po niego nie sięga.
Drugi duży test przeprowadziło SE Ranking na blisko 300 tysiącach domen. Nie znaleziono żadnej korelacji między obecnością pliku llms.txt a cytowaniem strony w odpowiedziach AI. Co więcej, model uczenia maszynowego, którym to sprawdzano, działał dokładniej dopiero po usunięciu pliku llms.txt z analizy. To sugeruje, że dziś ten plik wnosi raczej szum niż wartość. Realna adopcja według SE Ranking to zresztą tylko około 10 procent badanych domen.
Podsumowanie z danych jest jednoznaczne: na dziś nie ma dowodów, że plik llms.txt poprawia to, jak AI korzysta z Twojej strony, zwiększa ruch albo szansę na cytowanie firmy.
Co na ten temat mówi Google i dostawcy AI?
Tu nie trzeba zgadywać, bo Google napisało to wprost w dokumentacji. W przewodniku o widoczności w funkcjach AI (AI Overviews i AI Mode) czytamy: "Nie musisz tworzyć nowych plików czytelnych maszynowo, plików tekstowych dla AI ani znaczników, żeby pojawić się w tych funkcjach". Dokumentacja nie wymienia pliku llms.txt z nazwy, ale wynika z niej jasno, że żaden dodatkowy plik dla AI nie jest warunkiem pojawienia się w tych funkcjach. Osobno John Mueller z Google mówił wprost, że wyszukiwarka z pliku llms.txt nie korzysta. Źródło znajdziesz w dokumentacji Google Search.
Pozostali dostawcy też nie potwierdzili, że z niego korzystają. OpenAI odsyła do pliku robots.txt, a nie llms.txt. Anthropic sam publikuje swój plik llms.txt, ale nie deklaruje, że jego boty czytają cudze. Krótko mówiąc: standard nie został przyjęty przez żadną z firm, które realnie decydują o tym, co zobaczy użytkownik pytający asystenta AI o rekomendację.
Dlaczego powstała wersja druga, skoro boty nie czytają?
To uzasadnione pytanie: skoro dane z logów są tak jednoznaczne, po co w ogóle rozwijać standard? Odpowiedź jest taka, że moda i realne użycie to dwie różne rzeczy. Autor specyfikacji sam przyznaje, że przez dwa lata plik llms.txt opublikowały tysiące stron, i na tej podstawie przygotował wersję drugą, zaktualizowaną 10 sierpnia 2026 roku. Pojawiło się też wsparcie w narzędziach: audyt Lighthouse w Chrome sprawdza obecność pliku w ramach testów pod kątem przeglądania wspomaganego przez agentów AI.
Nie zmienia to jednak najważniejszego wniosku. Obecność pliku w specyfikacji i w narzędziach deweloperskich nie oznacza, że czyta go asystent, który odpowiada Twojemu klientowi. Standard dojrzewa raczej w stronę nawigacji dla agentów AI w dokumentacji niż w stronę dźwigni widoczności dla zwykłej firmy. Dlatego decyzję najlepiej oprzeć na własnych logach, a nie na numerze wersji.
Komu plik llms.txt faktycznie się przyda?
To nie jest tak, że plik llms.txt jest szkodliwy albo bezużyteczny dla wszystkich. Ma realny sens w jednym konkretnym przypadku: dla serwisów z dokumentacją techniczną. W pomiarach ograniczonych do stron deweloperskich plik publikuje grubo ponad połowa witryn - we wrześniu 2026 roku było to około 57 procent. Tę liczbę trzeba jednak czytać ostrożnie, bo taki panel celowo składa się głównie z firm technicznych i zawyża obraz. Poza branżą IT adopcja wciąż jest marginalna.
Powód tej popularności w dokumentacji jest praktyczny. Programiści na co dzień pytają asystentów AI, jak działa dane narzędzie, i sami wklejają im adres pliku llms.txt, żeby model szybciej trafił do właściwych stron. Jeśli więc Twoimi klientami są programiści albo kupujący techniczni, którzy korzystają z narzędzi AI wbudowanych w edytory kodu, taki plik może ułatwić im życie. Dla typowej małej firmy usługowej, sklepu czy gabinetu, którą wyszukuje zwykły klient, plik llms.txt nie jest jednak dźwignią widoczności. Traktuj go jak porządkowanie dokumentacji, a nie jak strategię na pojawienie się w AI.
Jak zrobić plik llms.txt krok po kroku?
Jeśli mimo wszystko chcesz go mieć, bo prowadzisz dokumentację albo po prostu wolisz niczego nie przegapić, zrobisz go w kilka minut. Pamiętaj tylko o kolejności: najpierw zadbaj o to, czego boty naprawdę przestrzegają, czyli o plik robots.txt, a dopiero potem o llms.txt.
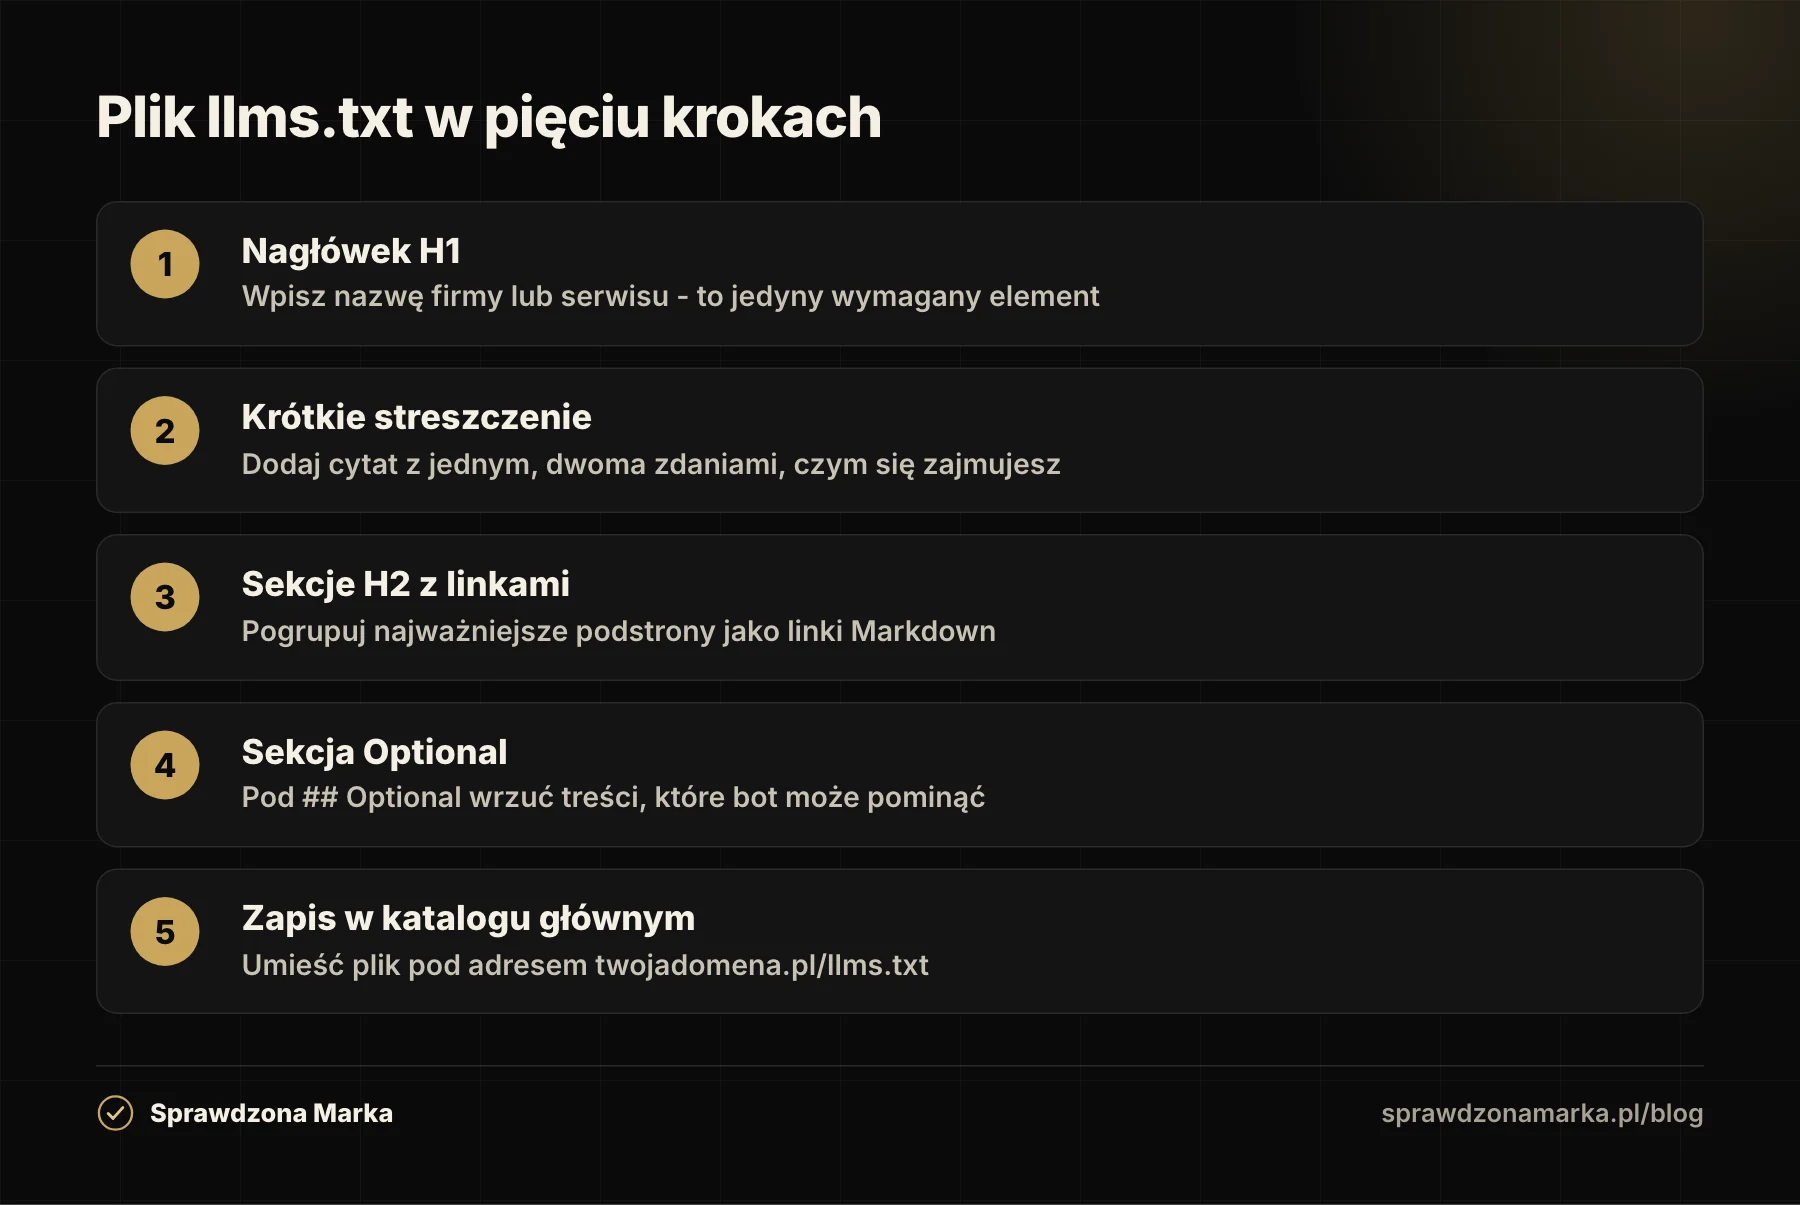
- Otwórz zwykły edytor tekstu i zacznij od nagłówka H1 z nazwą firmy lub serwisu. To jedyny obowiązkowy element.
- Dodaj krótkie streszczenie w formie cytatu (znak >): jedno, dwa zdania o tym, czym się zajmujesz.
- Pod nagłówkami H2 pogrupuj najważniejsze podstrony jako linki Markdown z krótkim opisem. To ma być wybór, a nie spis całej strony.
- Treści mniej istotne wrzuć pod sekcję
## Optional, którą bot może pominąć. - Zapisz plik jako llms.txt i wgraj go do katalogu głównego, pod adres
twojadomena.pl/llms.txt. - Sprawdź w logach serwera lub CDN, czy ktokolwiek po niego sięga. Filtruj po nazwach botów: GPTBot, ClaudeBot, PerplexityBot, Google-Extended.
Ten ostatni krok jest najważniejszy. Dzięki niemu po kilku tygodniach sam zobaczysz, ile razy boty AI realnie pobrały Twój plik, i nie będziesz musiał wierzyć nikomu na słowo.
Co zamiast tego naprawdę zwiększa szansę w Google i AI?
Dobra wiadomość jest taka, że czas, który chciałeś włożyć w plik llms.txt, możesz przeznaczyć na rzeczy, które według samego Google faktycznie się liczą. To wartościowa, niepowtarzalna treść, zdrowie techniczne strony, semantyczny HTML i dane strukturalne pod wyniki rozszerzone. O tym ostatnim pisaliśmy osobno: zobacz, jak dodać dane strukturalne LocalBusiness, bo to one, a nie plik tekstowy, w zrozumiały dla maszyn sposób opisują Twoją nazwę, adres, telefon i godziny otwarcia.
Google w tym samym przewodniku przypomina też o rzeczach pozornie oczywistych: strona musi być możliwa do zindeksowania, a treść widoczna dla robota bez logowania i bez blokady w pliku robots.txt. Jeśli te podstawy nie działają, żaden dodatkowy plik dla AI tego nie nadrobi.
W praktyce oznacza to kilka konkretnych ruchów. Opisz każdą usługę osobną, rozbudowaną podstroną zamiast jednym ogólnym akapitem. Zadbaj, by nazwa, adres i telefon brzmiały identycznie na stronie, w wizytówce Google i w katalogach branżowych, bo rozjazd w tych danych utrudnia maszynom złożenie spójnego obrazu firmy. Zbieraj i publikuj prawdziwe opinie oraz aktualizuj godziny otwarcia. To żmudne, ale właśnie te informacje modele językowe potrafią dziś realnie wykorzystać.
Zasada jest prosta: uporządkowane i potwierdzone informacje o firmie zwiększają szansę, że Google i asystenci AI je znajdą i wykorzystają. Zadbaj więc o spójne dane we wszystkich miejscach w sieci, o aktualną wizytówkę, o opinie i o jasne opisanie, czym się zajmujesz. Więcej konkretów znajdziesz w tekście o tym, jak budować widoczność firmy w AI.
Warto też, by wiarygodność firmy dało się potwierdzić w sposób sprawdzalny. Udział w programie weryfikacji, takim jak Sprawdzona Marka, pozwala pokazać, kto i co dokładnie sprawdził, oraz udostępnić numer, który klient i wyszukiwarka mogą zweryfikować online wraz z aktualnym statusem. To działa inaczej niż plik llms.txt: nie obiecuje, że AI poleci firmę, tylko porządkuje i czyni sprawdzalnymi fakty o niej - a to właśnie z takich informacji korzystają zarówno ludzie, jak i modele językowe.
Najczęściej zadawane pytania
Czy dodanie pliku llms.txt zaszkodzi mojej stronie?
Nie, sam plik niczego nie psuje. Z wypowiedzi przedstawiciela Google wynika, że wyszukiwarka z niego nie korzysta, więc nie wpłynie ani na plus, ani na minus na Twoje pozycje. Ryzyko jest inne: stracony czas, jeśli potraktujesz go jak gotowy sposób na pojawienie się w AI.
Czym różni się plik llms.txt od pliku robots.txt?
Robots.txt mówi botom, czego nie wolno im pobierać, i jest powszechnie przestrzegany. Llms.txt ma podpowiadać AI, co jest na stronie najważniejsze, ale nie jest obsługiwany przez większość crawlerów. W badaniach boty pobierały robots.txt tysiące razy, a llms.txt pojedyncze.
Jak sprawdzić, czy boty AI czytają mój plik llms.txt?
Zajrzyj do logów serwera lub panelu CDN i odfiltruj zapytania po nazwach botów, takich jak GPTBot, ClaudeBot, PerplexityBot czy Google-Extended. Jeśli pod adresem /llms.txt widzisz zero lub pojedyncze trafienia, masz odpowiedź na własnych danych.
Mam serwis z dokumentacją techniczną - czy wtedy warto?
Tak, to jedyny przypadek z realnym sensem. Programiści często wklejają asystentom AI adres pliku llms.txt, by szybciej trafili do właściwych stron dokumentacji. Dlatego wśród stron deweloperskich plik publikuje ponad połowa witryn, podczas gdy w zwykłych firmach usługowych jest to margines.
Skoro llms.txt nie działa, jak w ogóle pojawić się w odpowiedziach AI?
Postaw na to, co Google faktycznie bierze pod uwagę: wartościową treść, zdrowie techniczne strony, semantyczny HTML i dane strukturalne. Zadbaj też o spójne, potwierdzone informacje o firmie w sieci - to one zwiększają szansę, że asystenci AI je znajdą i wykorzystają.
Źródła
- The /llms.txt file, v2 - specyfikacja (2026-08-10)
- Ahrefs: Does llms.txt Actually Do Anything? (2026-11-18)
- Google Search Central: AI features documentation (2026-11-18)
- SE Ranking: llms.txt - what the data says (2026-11-18)
- Ezy.ai: We Put llms.txt on 83 Websites - server-log study (2026-07-19)
- GoodForBots: llms.txt adoption statistics - why studies disagree (2026-11-18)
Komentarze